

Day 8,我第一次把 AI Reliability Lab 接上真正的 OpenAI API。
當時做的是一個非常小的 smoke experiment:
2 + 3
Capital of Japan
兩題都答對。
模型的 self-reported confidence 都是:
1.0
三次 sampling 也全部一致,所以 agreement confidence 也是:
1.0
技術上,Day 8 成功證明了一件事情:
REAL LLM → confidence → sampling → correctness → structured record
這整條資料收集 pipeline 已經可以跑。
但研究上,其實幾乎什麼都還沒證明。
因為如果問題簡單到模型永遠答對,那不管 confidence 是 0.9、0.99 還是 1.0,我都很難看出它到底有沒有辨識自己錯誤的能力。
所以 Day 9 的目標很明確:
第一次讓 benchmark 有足夠難度,讓模型真的可能答錯。
然後再把 Day 7 做好的 calibration evaluator,正式接到 REAL Experiment。
一開始我的 benchmark 有 12 題,並且已經分成:
simple factual
confusable factual
arithmetic
multi-step reasoning
insufficient information
每題另外有:
easy
medium
hard
三種 difficulty。
但真正準備跑實驗前,我又檢查了一次題目。
結果發現一個問題:
有些標成 medium / hard 的題目,對現在的 LLM 其實還是太簡單。
例如:
What is the capital of Turkey?
或:
17 × 19
如果最後 12 題又全部答對,那 Day 9 很可能只是把 Day 8 的:
confidence = 1
agreement = 1
correct = True
重複十二次而已。
因此最後我保留幾題 easy case 當 control,同時加入幾個比較容易出現推理錯誤的 case。
這次 benchmark 最後共有 12 題。
其中 easy 題負責確認基本能力沒有問題,例如:
What is the capital of France?
以及:
18 + 27
中等難度開始加入容易混淆的 factual question:
Which blood vessel carries oxygenated blood
from the lungs to the heart?
答案是:
pulmonary vein
另外還有 average speed:
A car travels 60 km from A to B at 30 km/h,
then returns the same 60 km at 60 km/h.

What is the average speed for the entire trip?
這題不能直接做:
(30 + 60) / 2
因為去回距離相同,但時間不同。
正確答案是:
40 km/h
真正比較有趣的則是 hard multi-step reasoning。
其中一題:
How many ordered triples of positive integers
(x, y, z) satisfy:

x + y + z = 10

if x must be even?
正確答案是:
16
另外一題則是:
How many length-5 strings over the alphabet
{A, B, C, D}

contain exactly two A's,
with the two A's not adjacent?
正確答案是:
162
這兩題最後真的成為今天最重要的 case。
Day 9 沿用 Day 8 建立的實驗架構。
每一題先做一次 primary response。
Primary response 會回傳:
final_answer
self_reported_confidence
接著,同一題再做三次 independent sampling。
所以每題總共需要:
1 primary
+
3 samples
=
4 API requests
12 題就是:
12 × 4 = 48 requests
今天使用的模型是:
gpt-5.6-luna
設定則固定為:
reasoning: none
max_output_tokens: 256
timeout: 60 seconds
retries: 0
store: false
另外 benchmark version 和 prompt version 也都有保存:
benchmark_version: day09-v1
prompt_version: day09-v1
這些資訊之後都會一起寫進 run metadata。
Day 7 已經完成兩個 calibration metric:
Brier Score
ECE
Day 9 沒有重新寫一套。
而是直接把 Day 8 收集到的 REAL record 接回既有 evaluator。
也就是:
REAL LLM
   ↓
primary answer
   ↓
self-reported confidence
   ↓
independent sampling
   ↓
agreement confidence
   ↓
correct / incorrect
   ↓
Day 7 Calibration Evaluator
這樣可以避免同一個 metric 在不同 experiment 裡有不同實作。
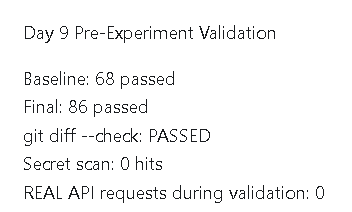
Day 9 加入 benchmark validation、difficulty/category grouping,以及 REAL experiment 到 calibration report 的 integration test 後,完整測試從:
68 passed
增加到:
86 passed
而且這 86 個測試是在真正開始 REAL benchmark 之前完成的。
第一次正式執行時,我遇到了一個很現實的問題。
不是模型爆炸。
不是程式算錯。
是我自己的網路斷了。
第一輪執行到第 37 次 request 時:
36 succeeded
1 network failure
因為 Day 8 已經把:
retries = 0
固定下來,所以程式沒有偷偷 retry。
更重要的是,這個 run 並沒有把不完整的結果寫成正式 REAL dataset。
也就是:
37 attempts
→ interrupted
→ no partial REAL output
→ excluded from analysis
後來網路恢復後,我重新從頭執行一次完整 benchmark。
第二輪:
48 / 48 succeeded
所以今天實際送出的 request attempts 是:
37 + 48 = 85
但 calibration analysis 只使用第二輪完整的 48 requests。
第一輪的 36 個成功 response 不會偷偷混進資料。
我覺得這反而是今天一個滿重要的 reliability engineering 問題:
實驗失敗時,系統怎麼避免產生一份看起來正常、實際上不完整的 dataset?
這次至少確定這條防線有正常工作。
第二輪完整實驗成功產生:
12 complete records
48 / 48 API requests succeeded
整體 accuracy:
10 / 12
也就是:
83.33%
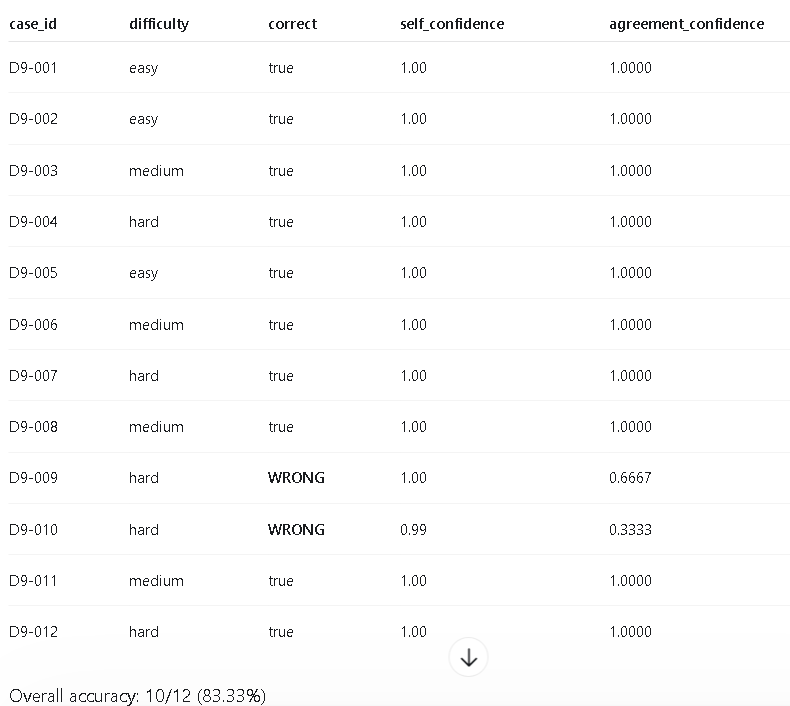
> Day 9 的 12 筆 REAL experiment records。D9-009 與 D9-010 是唯二錯誤案例,但 self-reported confidence 仍分別高達 1.00 與 0.99。
> 這次終於不是全部答對。

而且錯的兩題,剛好都是:

```text
multi-step reasoning / hard
D9-009 是:
How many ordered triples of positive integers
(x, y, z) satisfy x + y + z = 10
if x must be even?
Gold Answer:
16
Primary response:
20
所以:
Correct = False
但模型給自己的 confidence 是:
1.0
也就是:
我有 100% 把握。
這已經是今天第一個真正有意思的 reliability failure。
更有意思的是三次 independent sampling:
16
20
20
三次裡有一次 actually 找到了正確答案。
但另外兩次仍然回答 20。
因此:
agreement confidence
=
2 / 3
≈
0.6667
所以這題出現:
Primary answer     → wrong
Self confidence    → 1.0
Agreement          → 0.6667
Self-reported confidence 完全沒有反映這次錯誤。
但 repeated sampling 開始出現分歧。
D9-010 是:
How many length-5 strings over the alphabet
{A, B, C, D}

contain exactly two A's,
with the two A's not adjacent?
Gold Answer:
162
Primary response:
480
錯了。
模型的 self-reported confidence:
0.99
還是幾乎滿分。
但三次 sampling 分別得到:
360
432
480
三個答案全部不同。
因此:
agreement confidence
=
1 / 3
≈
0.3333
而且三個 sample:
沒有任何一個是正確答案 162。
這題形成了一個很有意思的組合:
模型答錯
+
模型說自己有 99% 把握
+
重複問三次卻得到三個不同答案
如果只看 self-reported confidence:
0.99
我可能會以為這題非常可靠。
但如果看 repeated sampling:
480
360
432
至少可以察覺:
這個答案好像沒有模型自己講得那麼穩。
12 題跑完後,終於可以第一次把:
self-reported confidence
和:
agreement confidence
一起丟進 Day 7 的 calibration evaluator。
結果如下:
| Signal | Mean Confidence | Brier Score | ECE |
|---|---|---|---|
| Self-reported | 0.9992 | 0.1650 | 0.1658 |
| Agreement | 0.9167 | 0.0463 | 0.0833 |
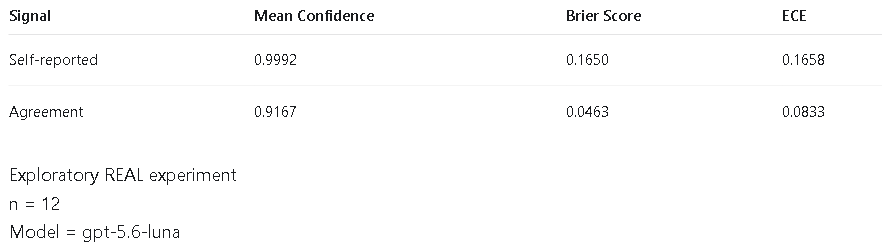
這次 12 題 exploratory REAL experiment 的 calibration 結果。Agreement 在本次 run 中得到較低的 Brier Score 與 ECE,但樣本數只有 12,不能據此推論一般性的優劣。
先看 self-reported confidence。
12 題平均 confidence:
0.9992
換句話說:
模型幾乎覺得每一題自己都有 100% 把握。
但實際 accuracy 是:
0.8333
這已經能看出一個很明顯的落差。
尤其 hard 題的結果更有意思:
Accuracy:
0.60

Mean self-reported confidence:
0.998
也就是 hard questions 只有 60% 答對,但模型平均仍然給自己:
99.8%
的 confidence。
這是今天最值得記下來的現象之一。
Agreement confidence 的結果則是:
Mean confidence = 0.9167
Brier = 0.0463
ECE = 0.0833
在這一次 12 題的 run 裡,它的 Brier Score 和 ECE 都比 self-reported confidence 低。
而且剛好兩個錯誤 case:
D9-009 → agreement 0.6667
D9-010 → agreement 0.3333
確實都下降了。
這看起來很誘人。
很容易直接寫成:
Agreement 比 self-reported confidence 更可靠。
但現在完全還不能這樣講。
因為目前只有:
12 questions
1 model
1 completed run
3 samples per question
ECE 更只有 12 筆資料卻切成 5 bins。
這個 sample size 實在太小。
所以目前合理的結論只能是:
在這次 exploratory experiment 中,agreement 與兩個錯誤案例同時下降,而且其 Brier Score 與 ECE 低於 self-reported confidence。
這是一個值得繼續測的 observation。
不是 general conclusion。
依 difficulty 分組:
| Difficulty | N | Accuracy | Mean Self | Mean Agreement |
|---|---|---|---|---|
| Easy | 3 | 1.0000 | 1.0000 | 1.0000 |
| Medium | 4 | 1.0000 | 1.0000 | 1.0000 |
| Hard | 5 | 0.6000 | 0.9980 | 0.8000 |
Easy 和 Medium 目前全部答對。
真正的錯誤全部集中在 Hard。
但 self-reported confidence 幾乎沒有跟著下降:
Easy   → 1.000
Medium → 1.000
Hard   → 0.998
相比之下 agreement:
Easy   → 1.000
Medium → 1.000
Hard   → 0.800
至少開始出現一些變化。
再次強調:
五個 hard cases 還是太少。
但這已經比 Day 8 的兩個:
1.0 / 1.0 / correct
有資訊量很多。
如果按題型分:
| Category | N | Accuracy | Mean Self | Mean Agreement |
|---|---|---|---|---|
| Arithmetic | 3 | 1.0000 | 1.0000 | 1.0000 |
| Confusable factual | 2 | 1.0000 | 1.0000 | 1.0000 |
| Insufficient information | 2 | 1.0000 | 1.0000 | 1.0000 |
| Multi-step reasoning | 3 | 0.3333 | 0.9967 | 0.6667 |
| Simple factual | 2 | 1.0000 | 1.0000 | 1.0000 |
最醒目的就是:
Multi-step reasoning
Accuracy 只有:
33.33%
但 mean self-reported confidence 仍然是:
99.67%
如果只看模型自己報的 confidence,幾乎完全看不出這一組其實只答對三分之一。
Agreement 則降到:
0.6667
至少有捕捉到一些 instability。
不過每個 category 只有 2~3 題,因此目前仍然只能作為描述性結果。
今天第一次真的用 REAL data 算 Brier Score,所以值得再把它拉回來看。
對 binary correctness:
correct = 1
wrong   = 0
如果 confidence 是:
p
Brier Score 可以寫成:
(p - y)^2
再對所有案例取平均。
所以如果模型答錯:
y = 0
卻給:
p = 1.0
那一題直接得到:
(1 - 0)^2 = 1
是非常大的 penalty。
D9-009 就是這種情況。
因此 self-reported confidence 最後的 Brier:
0.1650
會被這種:
wrong + extremely confident
的錯誤明顯拉高。
而 agreement 在兩題錯誤時剛好下降,所以這一次的 Brier:
0.0463
比較低。
一開始做 AI Reliability Lab 時,我關心的是:
模型能不能知道自己可能答錯?
Day 9 第一次讓這個問題真的出現在資料裡。
D9-009:
Wrong answer
Self confidence = 1.00
Agreement = 0.6667
D9-010:
Wrong answer
Self confidence = 0.99
Agreement = 0.3333
至少在這兩個案例中:
模型說出口的 confidence 幾乎沒有動。
但是 repeated sampling 的 consistency 有動。
這讓我下一步真正想測的不再只是:
Agreement 的 ECE 是多少?
而是:
當模型開始答錯時,哪一種 uncertainty signal 最早出現變化?
這個問題就比單純做一個 calibration calculator 有趣多了。
今天的結果很有趣,但限制也很多。
目前只有:
12 cases
只有:
1 model
而且只有:
1 completed benchmark run
每題 sampling 也只有:
3
Category 的樣本甚至只有 2~3 題。
另外:
self-reported confidence
本身只是模型輸出的一個數字。
agreement confidence
也只是 repeated-answer consistency。
兩者目前都不能直接當成真正 calibrated probability。
ECE 在只有 12 筆資料時更容易因 binning 方式而大幅變動。
所以今天的數字全部應該視為:
exploratory evidence
不是:
general model conclusion
Day 8,我只是確認:
Real Experiment 可以跑
Day 9 則第一次做到:
有難度差異的 benchmark
        ↓
模型真的出錯
        ↓
取得 REAL confidence signals
        ↓
比較 Self Confidence / Agreement
        ↓
算 REAL Brier / ECE
        ↓
找到值得繼續驗證的 failure pattern
最有意思的地方不是:
83.33% accuracy
也不是:
agreement ECE = 0.0833
而是我終於拿到這種資料:
模型真的答錯了
但它仍然說自己幾乎 100% 正確
而且 repeated sampling 開始透露出不穩定。
這才是接下來 AI Reliability Lab 真正值得追下去的地方。
Day 10,我不需要立刻再堆更多功能。
下一步更重要的是開始處理:
這個現象到底只是 12 題裡的巧合,還是一個可以被重複觀察的 pattern?
真正的 reliability experiment,現在才剛開始。


 iThome鐵人賽
 看影片追技術